用 AI Agent 从零构建生产级应用:架构与自进化治理体系
一、引言
AI Agent 能写生产级代码吗——不是 demo,不是原型,而是一个面向海量用户的多站点加密货币交易 App?
我们做到了。百万行级 Dart 代码、数万个文件、跨多种语言共数百万行——全部由 AI Agent 生成。没有人类逐行写代码,人类只定义约束和审批架构决策。
本文分三个部分:
- 应用架构——AI 必须遵守的 Clean Architecture 分层与多站点分发
- 治理体系——约束 AI 行为的四层规约系统
- 自进化闭环——治理体系如何从每次犯错中自我改进
二、架构全景
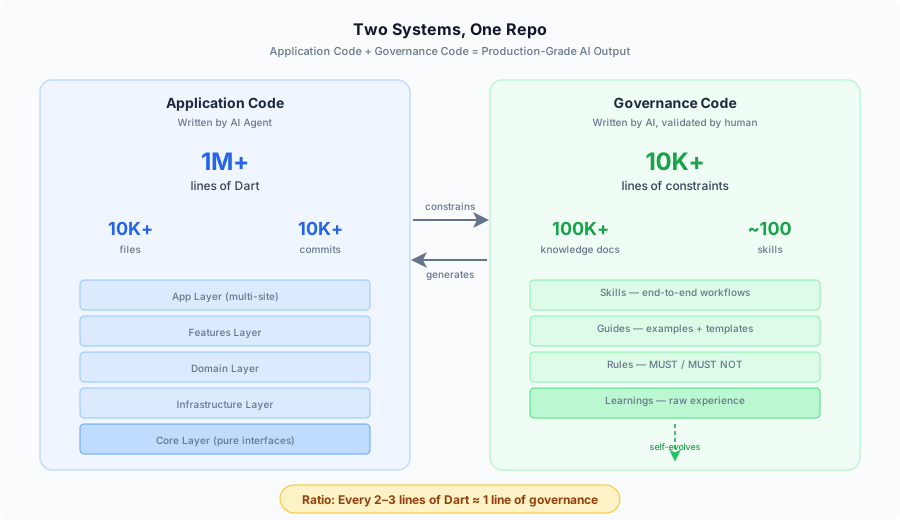
两套系统,一个仓库
| 维度 | 应用代码 | 治理代码 |
|---|---|---|
| 体量 | 百万行级(Dart) | 数万行规约 + 数十万行知识文档 |
| 生产者 | AI Agent | AI Agent(人类确认) |
| 进化方式 | 功能迭代 | 从犯错中自进化 |
| 验证手段 | 类型检查 + 测试 + 门禁脚本 | Gate 脚本 + 契约断言 |
| 比例 | — | 每 2~3 行 Dart 对应约 1 行 Markdown |
最后这个数字最有说服力:代码和治理的投入几乎是 1:1 量级。这就是让 AI 写出生产级代码的真实代价。
三、应用架构——AI 必须遵守的边界
3.1 五层 Clean Architecture
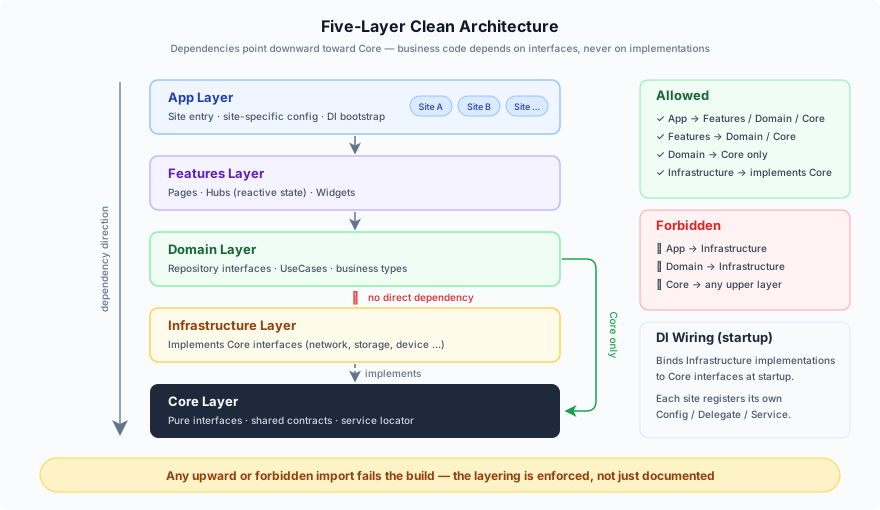
| 层级 | 职责 |
|---|---|
| 应用层(多个区域站点) | 站点入口、站点配置、DI 启动 |
| 功能层 | 页面、状态容器(Hub)、组件 |
| 领域层 | Repository 接口 + UseCase |
| 基础设施层 | 实现 Core 接口(网络、存储、设备等) |
| 核心层 | 纯接口 + 共享契约 |
依赖方向严格指向 Core:业务代码只依赖接口、不依赖实现;领域层与基础设施层互不依赖,二者都只面向 Core,实现由 DI 在启动时装配。违反即构建失败。这条规则以一小段文本的形式始终加载到每次 AI 对话中——像硬件级约束一样不可绕过。
3.2 多站点零硬编码分发
应用服务多个区域市场,功能、合规、UI 各有差异。差异化机制:
| 机制 | 何时用 | 原理 |
|---|---|---|
| Config | 某个值/开关各站不同 | 抽象类 + 默认值,各站 override |
| Delegate | 某个行为步骤各站不同 | 抽象类 + 默认实现,各站 override 一个方法 |
| Service | 整段能力各站完全不同 | 接口,各站提供完全不同的实现 |
共享代码中零 if (site == 'xxx') 判断。 DI 多态本身就是分发——每个站点启动时注册自己的实现,运行时切站原子重注入。
3.3 响应式状态管理
状态层采用 Signal 体系(类似 Solid.js 的 Signals,但在 Dart 中实现):
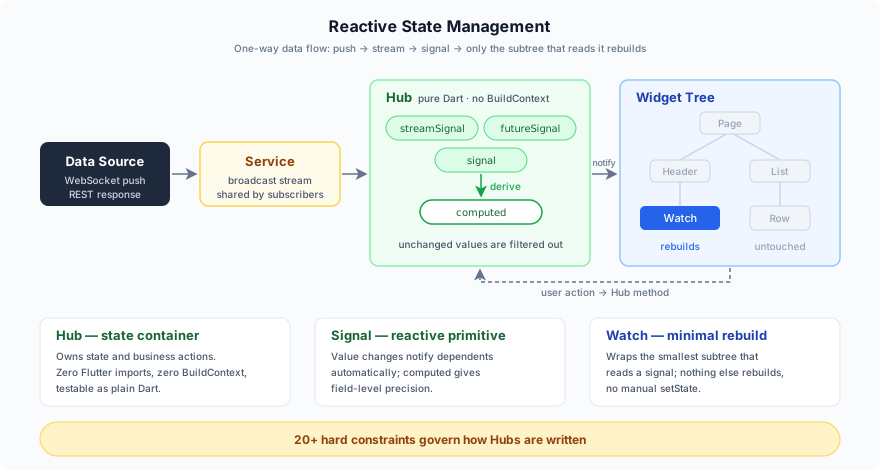
数据单向流动:WebSocket 推送 → Service(broadcast stream)→ Hub(StreamSignal)→ Widget(最小子树重建);用户操作则通过调用 Hub 方法回到状态层。
- Hub = 纯 Dart 状态容器(零 UI 框架导入,零 BuildContext)
- Signal = 响应式原语(值变化 → 依赖者自动重建)
- Watch = 最小子树重建(只有读取该 Signal 的组件重建)
二十余条硬约束治理 Hub 的编写方式,每一条都来自开发实践中总结的经验。
四、治理体系——约束 AI 的四层架构
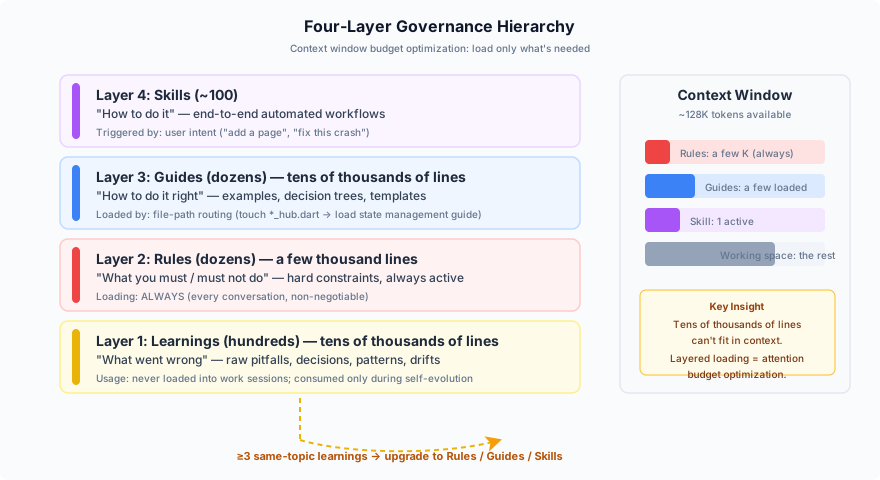
4.1 四层规约层级
| 层级 | 数量 | 行数 | 加载策略 | 职责 |
|---|---|---|---|---|
| Rules(铁律) | 数十条 | 数千行 | 始终加载(每次对话) | MUST / MUST NOT 硬约束 |
| Guides(指南) | 数十份 | 数万行 | 按需加载(路径路由命中) | 完整示例、决策树、代码模板 |
| Skills(技能) | 近百个 | — | 意图触发 | 端到端自动化工作流 |
| Learnings(教训) | 数百条 | 数万行 | 自进化时消费 | 原始经验:陷阱、决策、模式 |
为什么分四层而不是一个大文件?
上下文窗口有限。把数万行规约全部加载进每次对话是不可能的。分层设计是注意力预算优化:
- Rules(数千 tokens):始终加载——违反它们 100% 是 bug
- Guides:只在 AI 触及相关文件路径时加载
- Skills:只在用户意图匹配时加载
- Learnings:从不加载到工作对话中——只在进化时消费
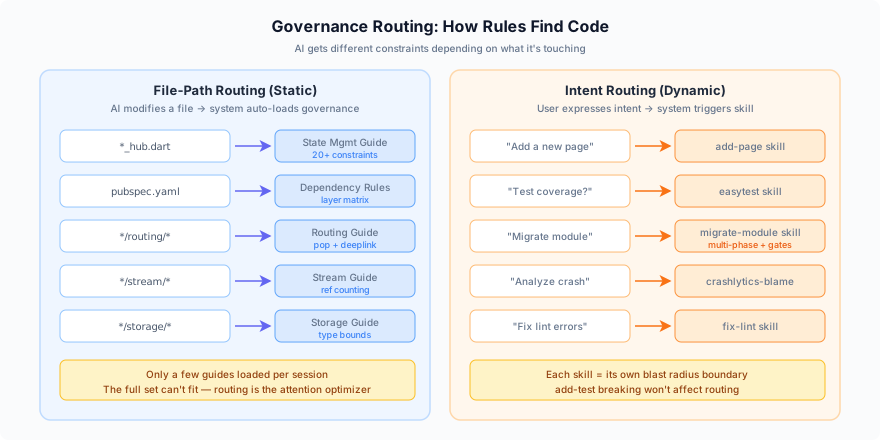
4.2 文件路径路由
AI 修改一个文件时,系统自动加载对应规约:
| 文件路径模式 | 加载的治理内容 |
|---|---|
| 路由相关文件 | 路由指南 + pop 契约 + deeplink 编码规约 |
*_hub.dart | 状态管理指南(二十余条约束) |
| 存储相关文件 | 存储指南(类型边界、加密分级) |
pubspec.yaml | 依赖规则(层级矩阵) |
| WebSocket / stream 文件 | Stream 订阅指南(引用计数、死流陷阱) |
意味着 AI 根据正在修改的代码获取不同的指令——像语义级的 linter,但能表达运行时约束。
4.3 意图路由
用户表达意图时,系统路由到对应技能:
| 用户说 | 触发的技能 | 执行内容 |
|---|---|---|
| "加一个新页面" | add-page | 生成路由 + 页面 + 状态容器 + DI 注册 |
| "覆盖率多少" | easytest | 查询覆盖率数据,诊断缺口,建议下一步 |
| "迁移这个模块" | migrate-module | 多阶段工作流,阶段间有门禁断言 |
| "分析这个崩溃" | crashlytics-blame | 解析堆栈、git blame、复现、定位根因 |
4.4 反幻觉协议
AI 生成代码的第一风险不是风格——是编造。AI 可能:
- Import 一个不存在的类
- 从命名模式推断一个它发明的 API 路径
- 不验证就假设某个方法签名
生成代码前的五个强制步骤:
- 调查 — 读实际文件再下结论,禁止臆测
- 反思 — 每次工具调用前一句话说清 why/what/how
- 生成知识 — 落笔前先列 2-3 条可验证事实
- 复用优先 — 先搜既有代码/库,标注来源和置信度
- 验证 — 自检是否有实体/关系/上下文编造,无源可溯的删掉
顶层硬规则:
- 金融数据(价格、汇率、合约参数)——绝不允许编造
- 文件路径——生成前必须
ls父目录确认 - 标识符——禁止从命名模式推断,先 grep 验证
五、技能系统——从"写代码"到"执行工作流"
5.1 技能不是 Prompt 模板
一个技能 = 一个端到端的自动化工作流:
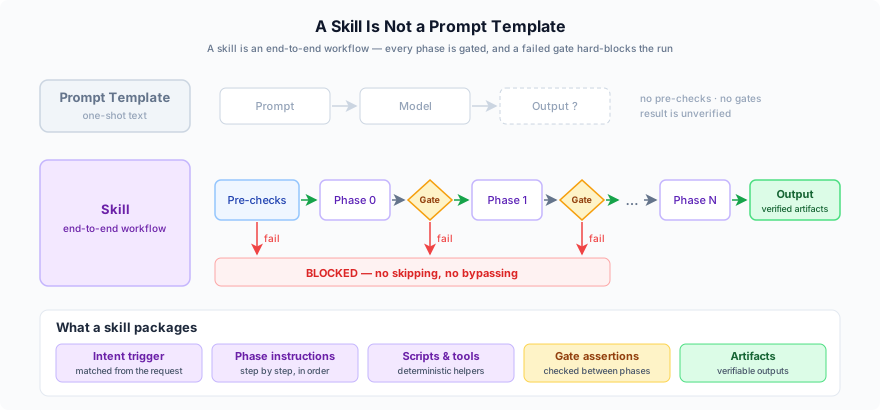
Prompt 模板是一次性文本:喂给模型、拿回输出,没有前置检查、没有门禁,结果是否正确无从验证。技能则把意图触发、分阶段指令、确定性脚本、门禁断言和产出物打包在一起:
前置检查 → Phase 0 → Gate 断言 → Phase 1 → Gate 断言 → ... → Phase N → 产出物如果某阶段的门禁断言不通过,工作流硬阻断——不能跳过、不能绕过。
5.2 技能的分类
| 类别 | 代表 | 能力 |
|---|---|---|
| 代码生成 | 新增页面、新增状态容器、新增服务 | 从零生成符合架构的代码 |
| 测试 | 补测试、用例转测试、覆盖率追踪 | 代码→测试、用例→测试 |
| 迁移 | 模块迁移、图片迁移 | 旧系统→新系统 1:1 搬运并验证 |
| 质量 | 质量收敛、lint 修复、代码审查 | 自动化质量守护 |
| 运维 | iOS 构建修复、磁盘清理 | 开发环境修复 |
| 分析 | 崩溃分析、MR 理解 | 问题诊断 |
5.3 技能边界 = 爆炸半径边界
关键设计决策:技能有严格的输入边界。
例:覆盖率缺口来自 lcov(代码事实)→ 走代码驱动技能。QA 用例未转测试(用例事实)→ 走用例驱动技能。二者不可交叉——一旦混用,两类技能的职责和产出就会互相污染。这类问题会被记录为 learning,累积到一定程度后升级为正式规约。
六、自进化闭环——治理体系如何自我改进
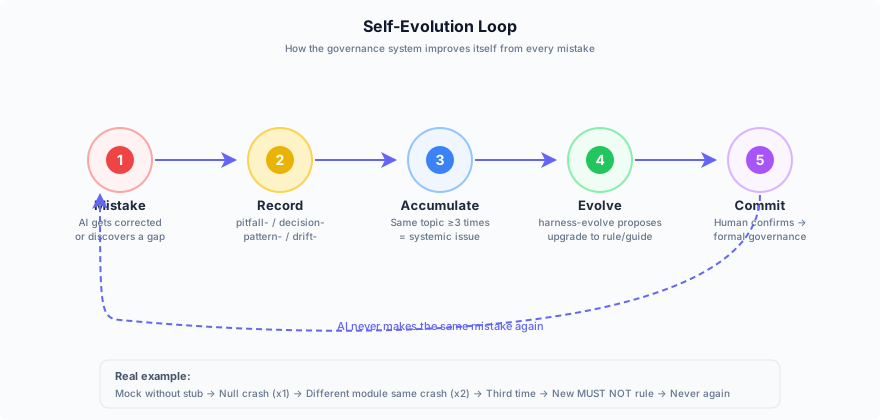
6.1 闭环流程
犯错 / 被纠正 / 发现有效模式
        ↓
记录到 learnings(pitfall- / decision- / pattern- / drift-)
        ↓
同主题累积 ≥3 条
        ↓
触发 harness-evolve → 提议升级为 rules / guides / skills
        ↓
人类确认 → 正式规约(提交到 Git,团队共享)
6.2 教训的五种触发时机
| 触发场景 | 教训前缀 | 示例 |
|---|---|---|
| AI 被纠正 | pitfall- | "禁止用 Stream.value mock 持续订阅型 stream" |
| 规约缺口 | pitfall- / pattern- | "没有规约覆盖测试中的存储 schema 迁移" |
| 架构决策 | decision- | "选 DI 多态而非 Feature Flag 做站点差异化" |
| 技能执行偏差 | drift- | "migrate-module 跳过了 Phase 2 门禁检查" |
| 有效模式验证 | pattern- | "基于属性的排序测试比精确匹配更稳定" |
6.3 进化实例
一个典型的通用案例:
第 1 次:AI 写了一个 Mock 类但没有 stub 所有被消费的 getter → 测试崩溃 Null is not subtype of bool。记录教训。
第 2 次:不同模块出现相同模式。再次记录。
第 3 次:第三次出现,触发 harness-evolve。系统提议新增一条 MUST NOT 规则:
"禁止声明 Mock 类后不 stub 生产代码消费的所有 getter/method"
人类确认 → 规则提交。AI 再也不犯这个错误。
6.4 为什么不一开始就写好所有规约?
因为你不知道你不知道什么。
粗粒度约束可以预设(如"应用层禁止导入基础设施层")。但细粒度陷阱(如"mocktail 的 any(named:) 对抽象参数需要提前注册 FallbackValue")只有真正踩过才会发现。
Learning 池是这个发现过程的累积器。Rules 是蒸馏后的智慧;Learnings 是原始经验。
七、质量门禁——最后一道防线
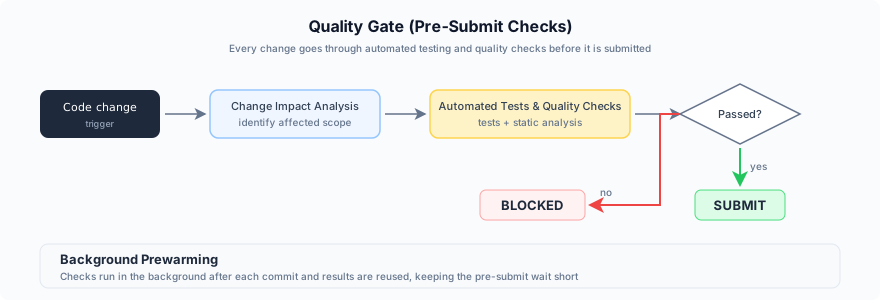
7.1 提交前质量检查
代码提交
  ├─ 识别本次变更的影响范围
  ├─ 运行自动化测试与质量检查
  └─ 检查不通过 → 阻断提交
每次提交前都会进行自动化测试与质量检查,只有检查通过的变更才能进入代码库。
7.2 后台预热
提交后在后台提前执行检查并复用结果,把提交前的等待时间从分钟级缩短到秒级。
7.3 变更管理
即使治理体系本身的变更也走正式流程:
提案 → 设计 → 任务拆分 → 实施 → 验证 → 归档上百个正式变更通过此流程管理。防止"规约漂移"——即规约累积矛盾而无人整体审视。
八、实战数据
| 指标 | 值 |
|---|---|
| Dart 代码 | 百万行级 |
| 全语言总代码 | 数百万行(跨多种语言) |
| 文件总数 | 数万个 |
| Git commits | 上万次 |
| 治理规约 | 数万行(Rules + Guides + Learnings) |
| 知识文档 | 数十万行(含设计文档、使用指南) |
| 技能 | 近百个 |
| 正式变更 | 上百个 |
| 自进化教训 | 数百条 |
| 区域站点 | 多个 |
| 组件包 | 十余个 |
九、设计权衡
1. 为什么 Rules 始终加载而非全部按需?
违反 Rules 的代码 100% 是 bug(如跨层依赖)。不能依赖路由命中来拦截——必须在每个上下文窗口中。代价是每次对话永久占用数千 tokens。
2. 为什么要 ≥3 次复现才升级为正式规约?
一次教训可能是 corner case。三次复现证明它是系统性问题。过早的规约会制造虚假约束。
3. 为什么近百个技能不合并成更少的通用技能?
技能边界 = 爆炸半径边界。add-test 出问题只影响测试,不会搞坏路由。合并技能就是合并它们的故障模式。
4. 为什么不用自动化 lint 替代文字规约?
Lint 只能检查语法模式。它无法表达"切站时缓存的 DI 引用会过期"这种运行时语义约束——这需要自然语言解释 why + 示例代码展示 how。
5. 为什么不让人类写关键部分的代码?
一致性。一个严格遵守铁律的 AI 产出的代码,比 5 个习惯不同的人类产出的代码在架构一致性上更强。治理体系就是那个"资深工程师"——只不过它由文本文件构成。
6. 代价是什么?
上下文窗口消耗。铁律始终占用数千 tokens,意味着每次对话的有效工作空间相应减少。这是 AI 治理的根本 tradeoff:注意力 vs 正确性。
十、结语
让 AI 写代码不难。让 AI 持续写正确的代码,需要一套与代码库同等投入的治理体系。
我们的治理体系不是一次性设计出来的——它是数百条教训、上百次正式变更的产物。每条铁律、每条教训都来自实践中的真实反馈。
AI 编码的真正 scaling law:代码可以无限生成,但治理必须同步进化。
记住三个数字:
- 1 : 2~3 —— 治理文档与 Dart 代码的行数比,接近 1:1 量级
- 数百 —— 系统稳定前累积的教训条数
- 近百 —— 把"写代码"变成"执行经过验证的工作流"的技能数
一句话总结:让 AI 持续正确地写代码,靠的不是更聪明的模型,而是一个跟代码库共同进化的治理系统。