figma-to-code:快速、稳定、低成本的 D2C 方案
TL;DR
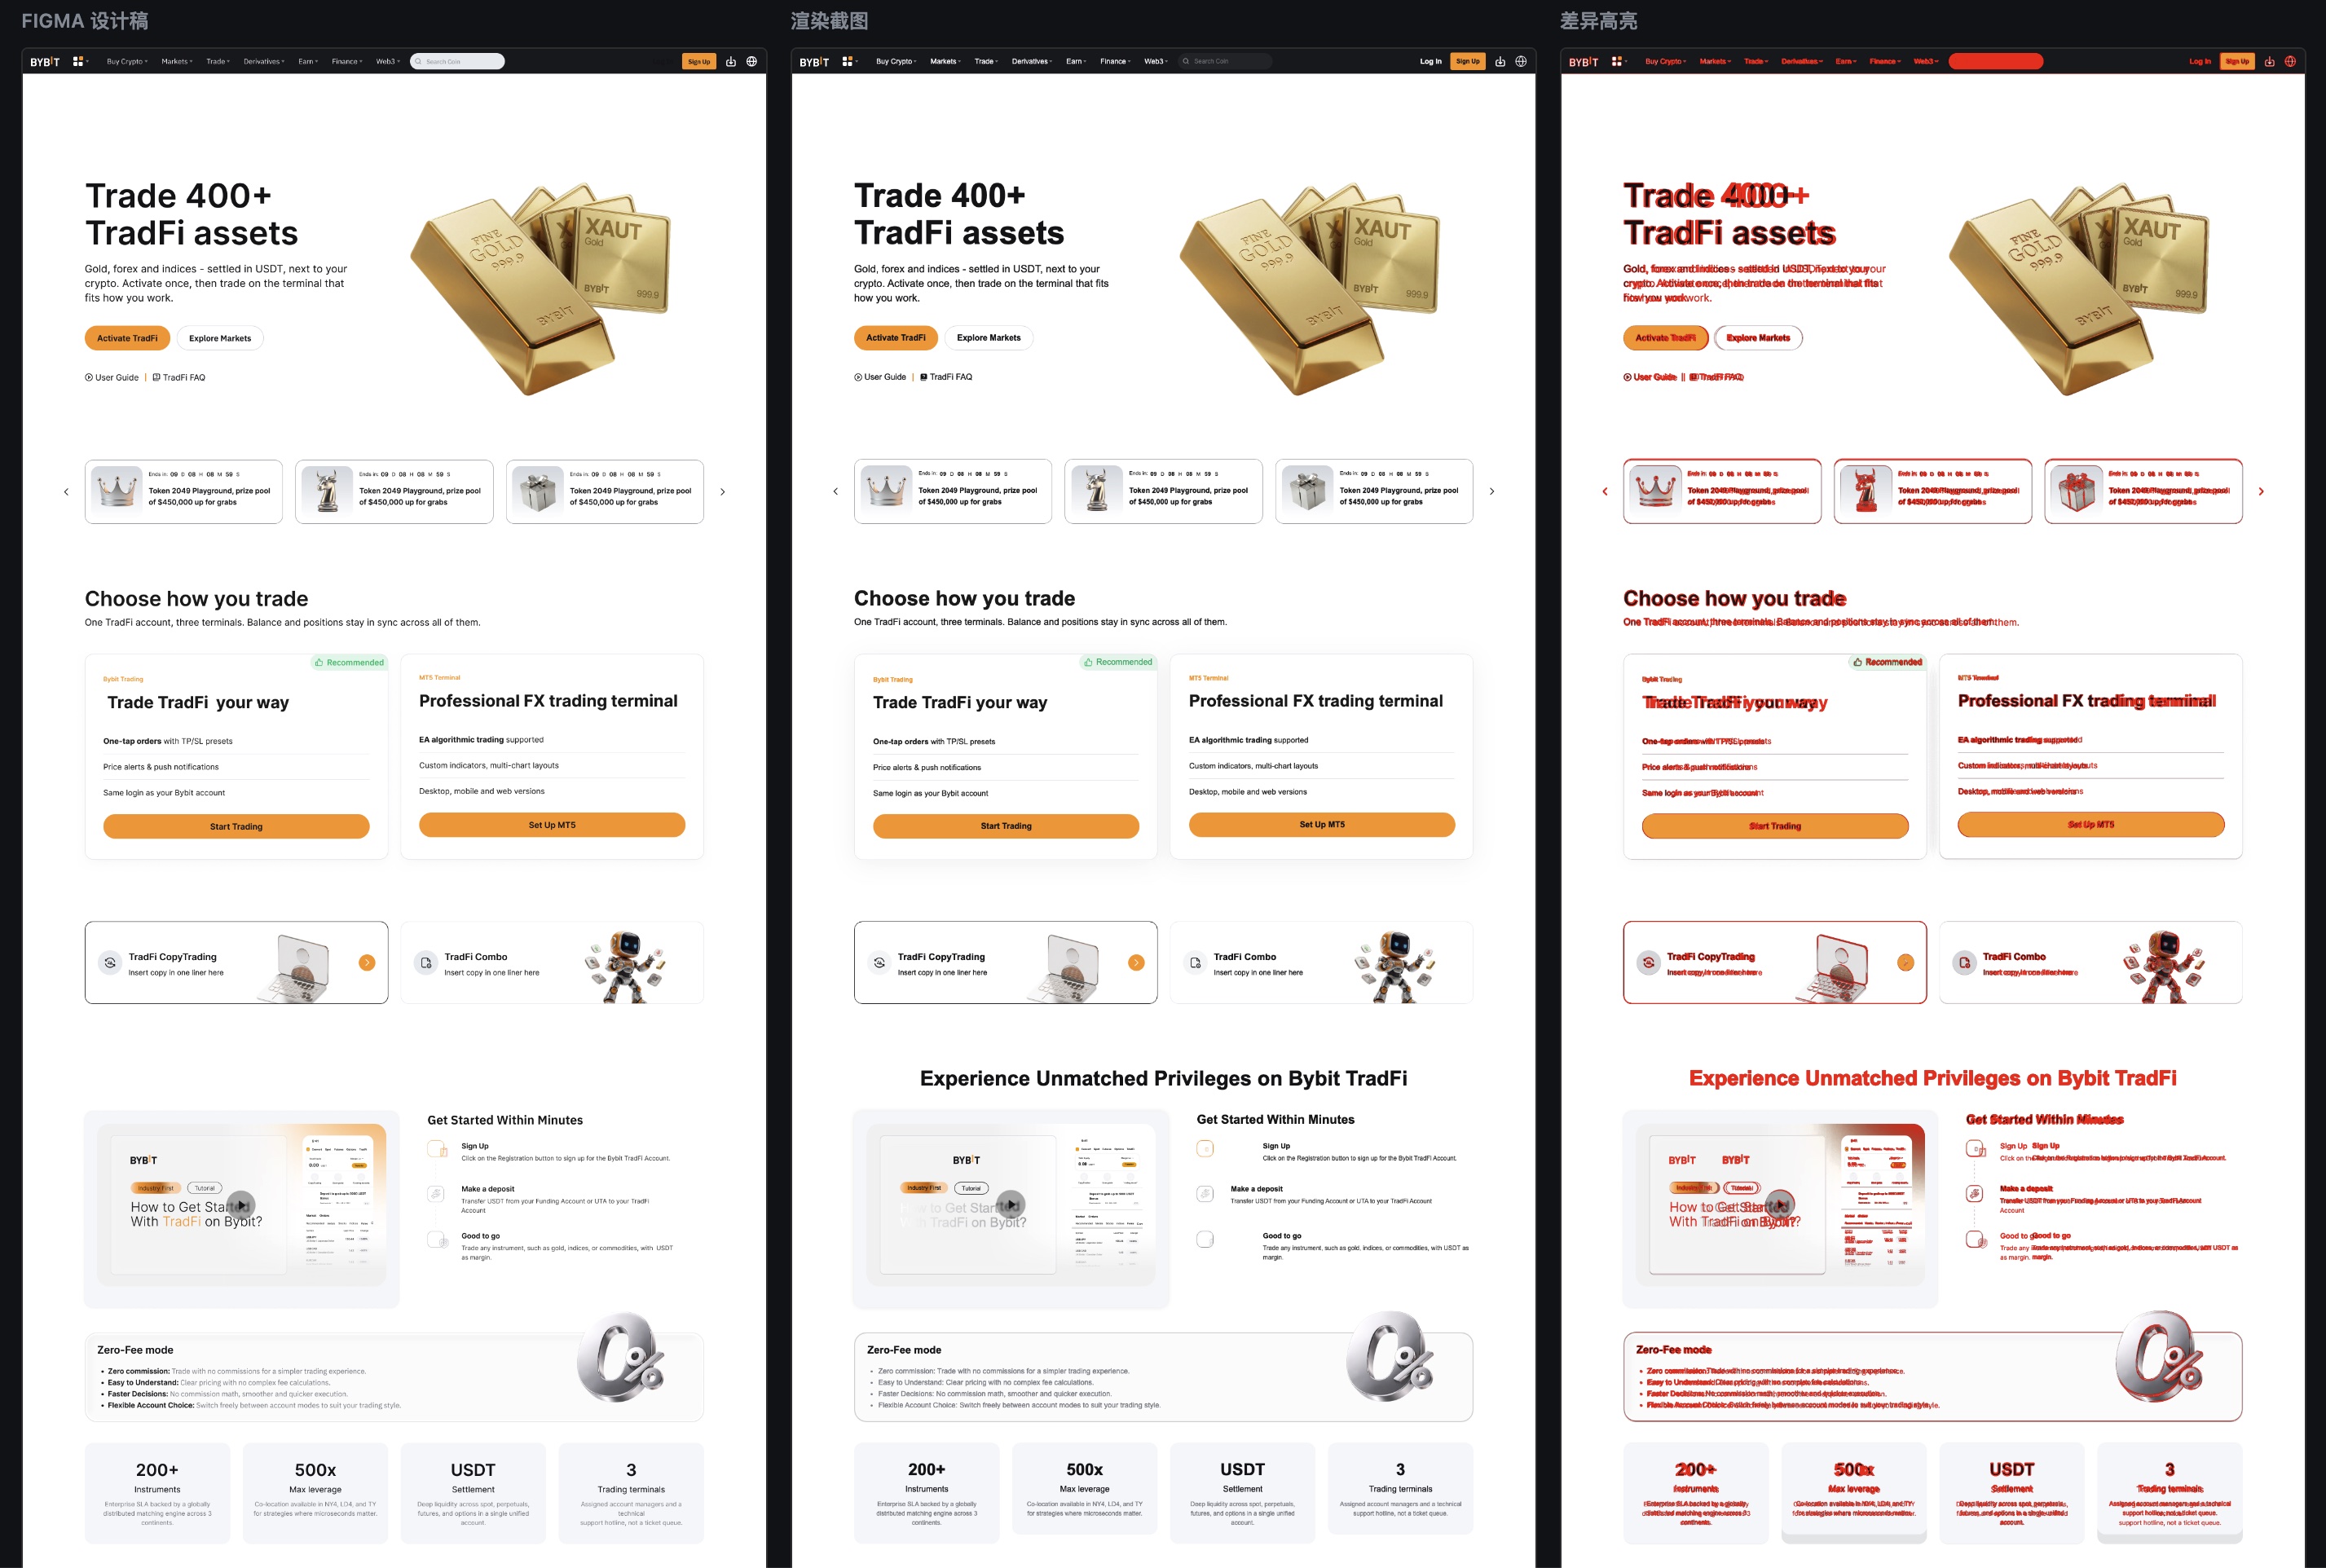
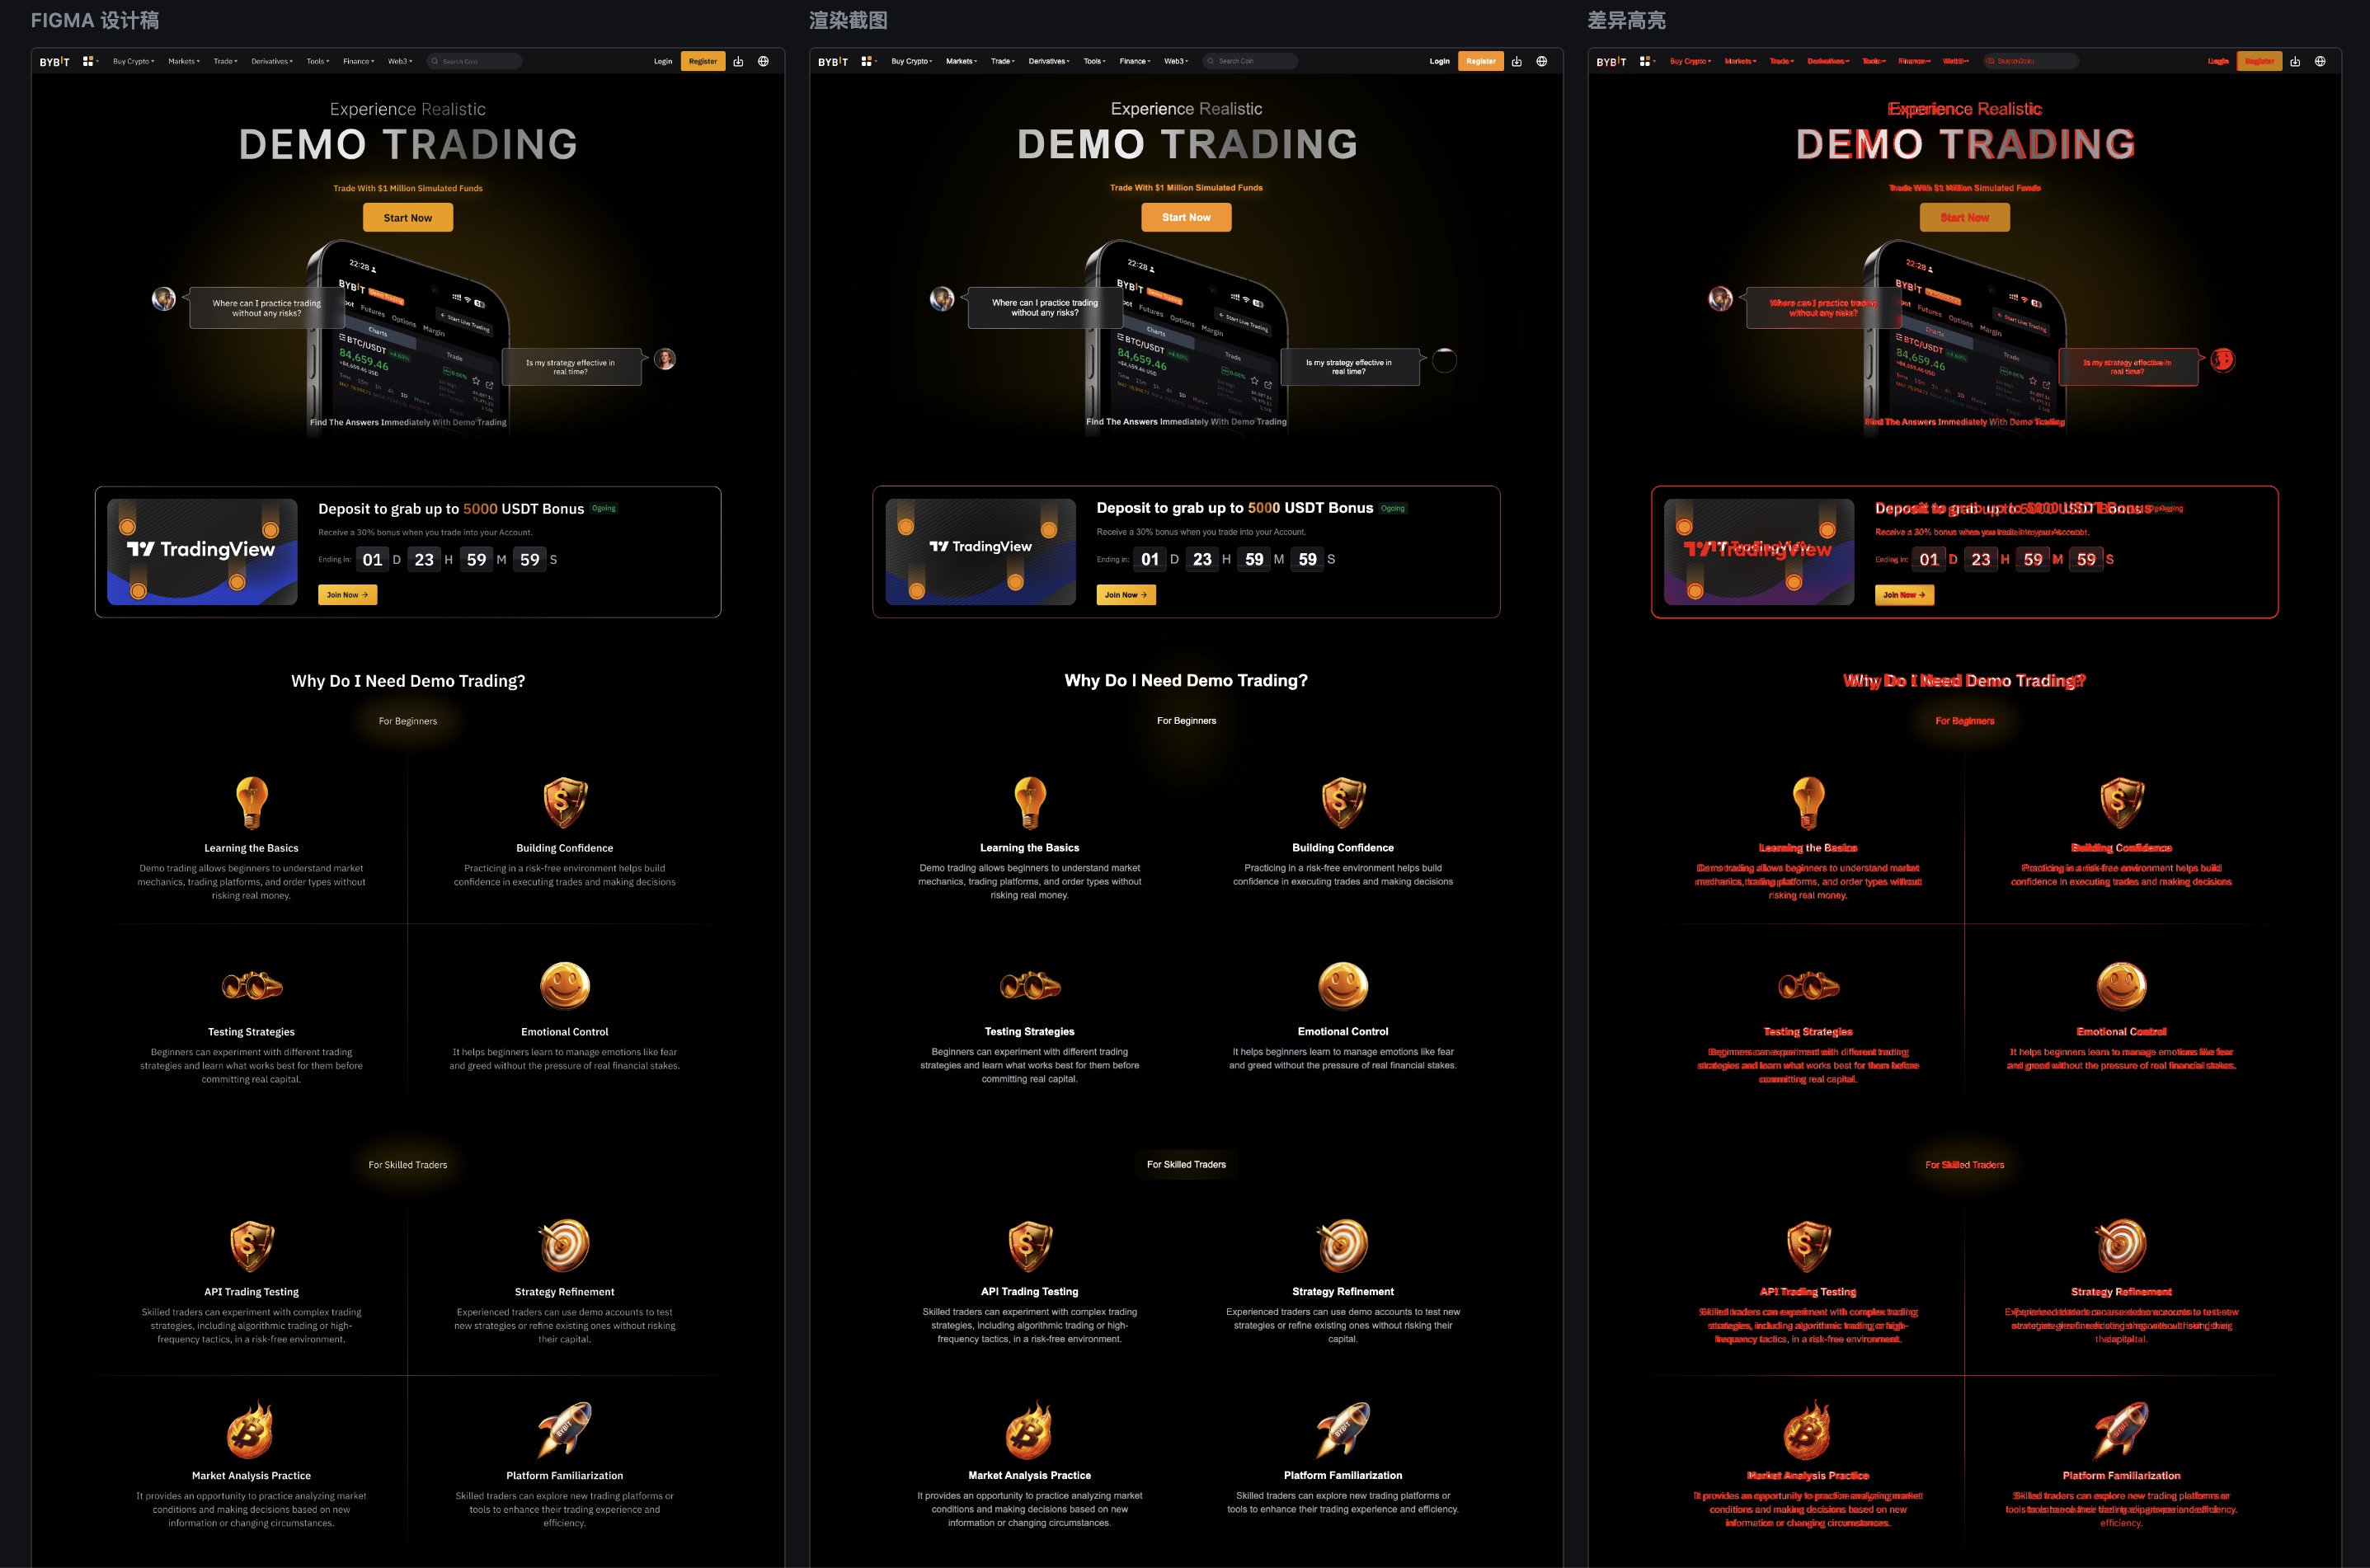
三个数字先说清楚:整稿首轮像素还原度 90%+,完成时间 ≤15 分钟,上下文消耗约 100K tokens(MacBook M5 Pro)。
给一个 Figma URL,自动产出 React + CSS Modules 代码,设计 Token 自动对应、组件库自动识别、PC + H5 双端同时支持,代码可直接落地。
为什么能做到:不是让 AI 看图猜数字,而是把 Figma 的结构化数据提前转成 AI 友好的格式,让 Coding Agent 在写码过程中按需查询精确的 CSS 值——就像有经验的前端开发者会反复切回设计稿确认细节,而不是全靠记忆推断。工程化管线负责所有确定性的事,AI 只处理需要理解能力的部分。由于核心还原逻辑由确定性脚本完成,Haiku 和 Opus 跑同一份设计稿产出完全一致——还原效果由工程管线决定,与模型选择无关。
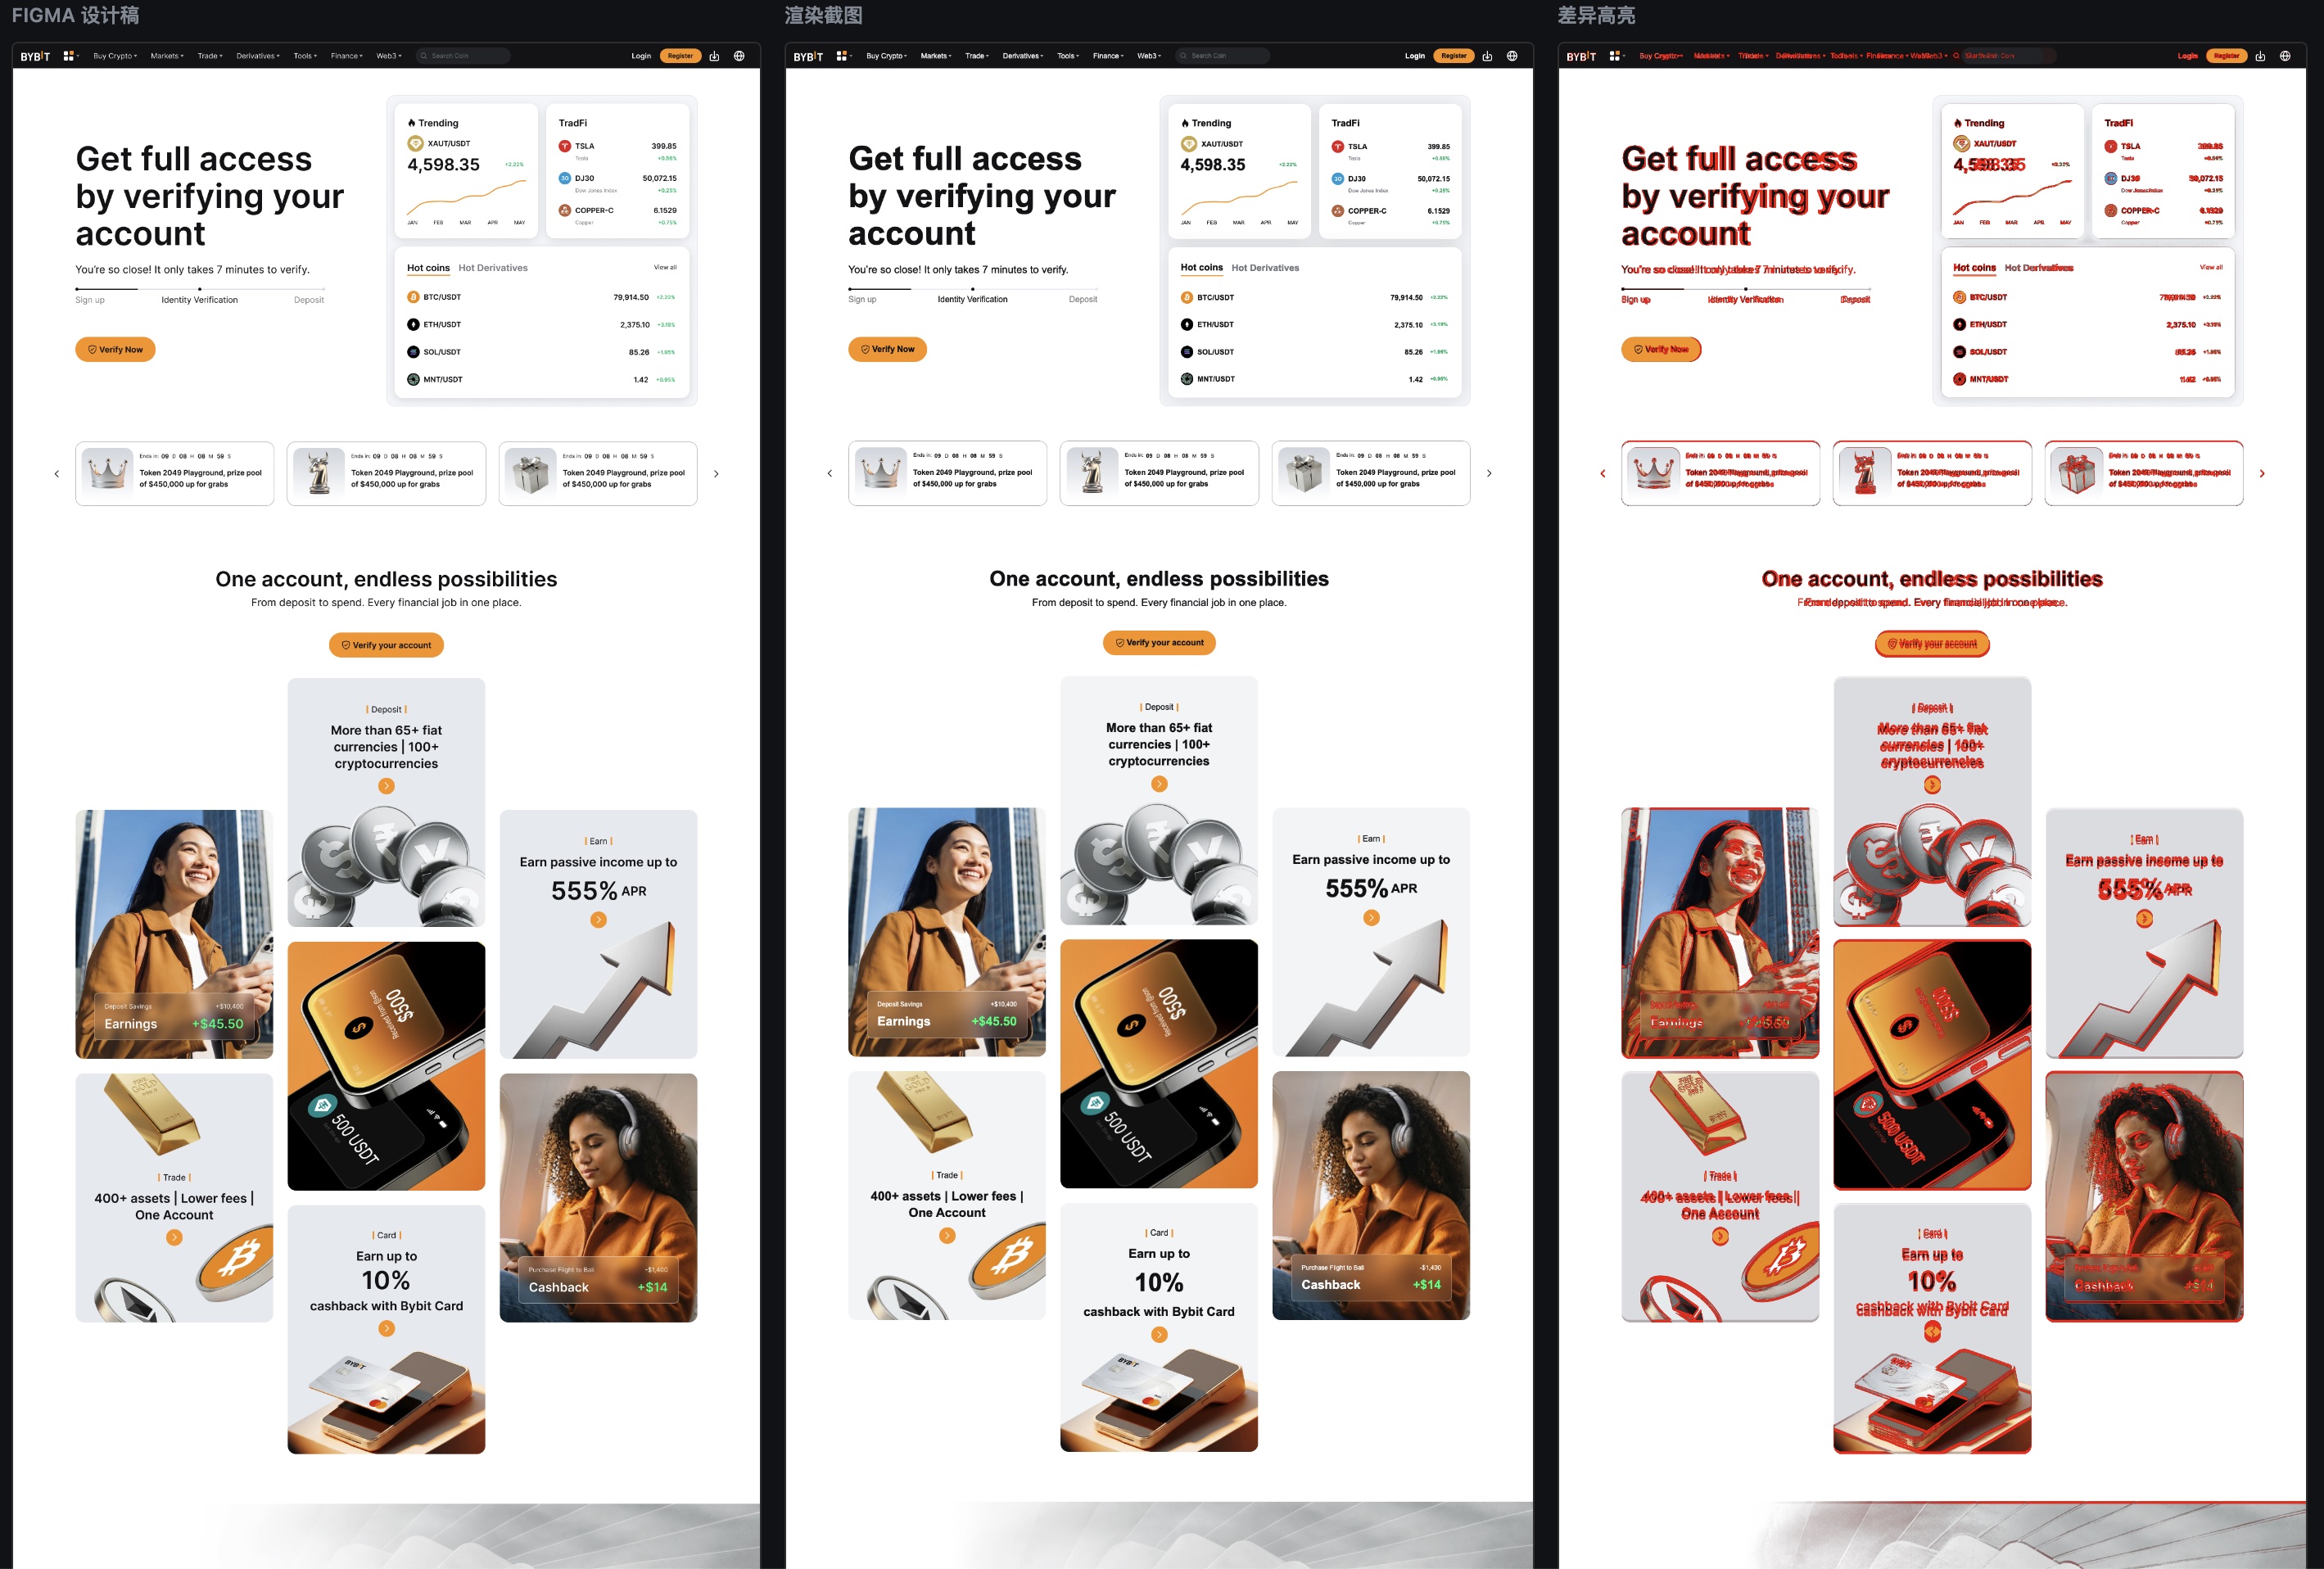
背景:AI Coding 时代,设计稿还原卡在哪里
AI Coding 工具正在快速重塑前端研发流程。Claude Code、Cursor、Copilot 已经在大量日常需求中替代了手写代码的环节——逻辑实现、接口对接、单元测试,这些任务里 AI 的完成质量越来越可靠。但有一个环节一直是短板:视觉还原。Landing Page、活动页面、品宣页——这类页面对视觉精度要求极高,而 AI 在这里恰恰最不稳定:
- 首轮还原度不可预测:同样的设计稿,不同模型、不同会话,结果差异可以很大
- 修正循环消耗大:达到 90% 还原度往往需要多轮迭代,每轮都消耗大量上下文,耗时可长达数小时
- 人工参与无法省掉:AI 生成代码后,视觉走查几乎必然需要人工介入,像素偏差、间距错误、色差反复出现,是前端团队日常绕不开的问题。
具体到前端团队,这个问题还叠加了几个额外的维度:
- 项目 Design Token 在设计稿色值与代码变量之间存在一层映射,不是简单的直接对应,需要人工维护转换表
- 设计稿通常只出一套主题,多主题适配需要额外处理
- 业务组件库与 Figma 组件的对应关系需要维护,否则 AI 大概率用 div 重写一遍
即使 Figma 官方提供了 AI 转码能力,在满足项目级定制化需求(Design Token 对接、组件库映射、多主题适配)上仍有明显差距。这就是 figma-to-code 面对的核心场景。在深入根因之前,先确立衡量标准——一个真正解决这个问题的方案,需要在这四个维度上同时表现良好:
根源在哪里?要从 Figma 数据的格式本身说起。
视觉还原为什么总是最棘手
不是 AI 能力不够。现在的模型完全能写出样式代码。问题在于它拿到的信息格式。
调用 Figma REST API,返回的是完整节点树:复杂图层结构、蒙版、装饰叠加、多画板状态……这些数据是为设计师构建的,不是为代码执行准备的。把原始节点树直接给 AI,大多数时候只有两种结果:上下文爆炸,或者 AI 忽略大部分信息、靠截图猜数字。
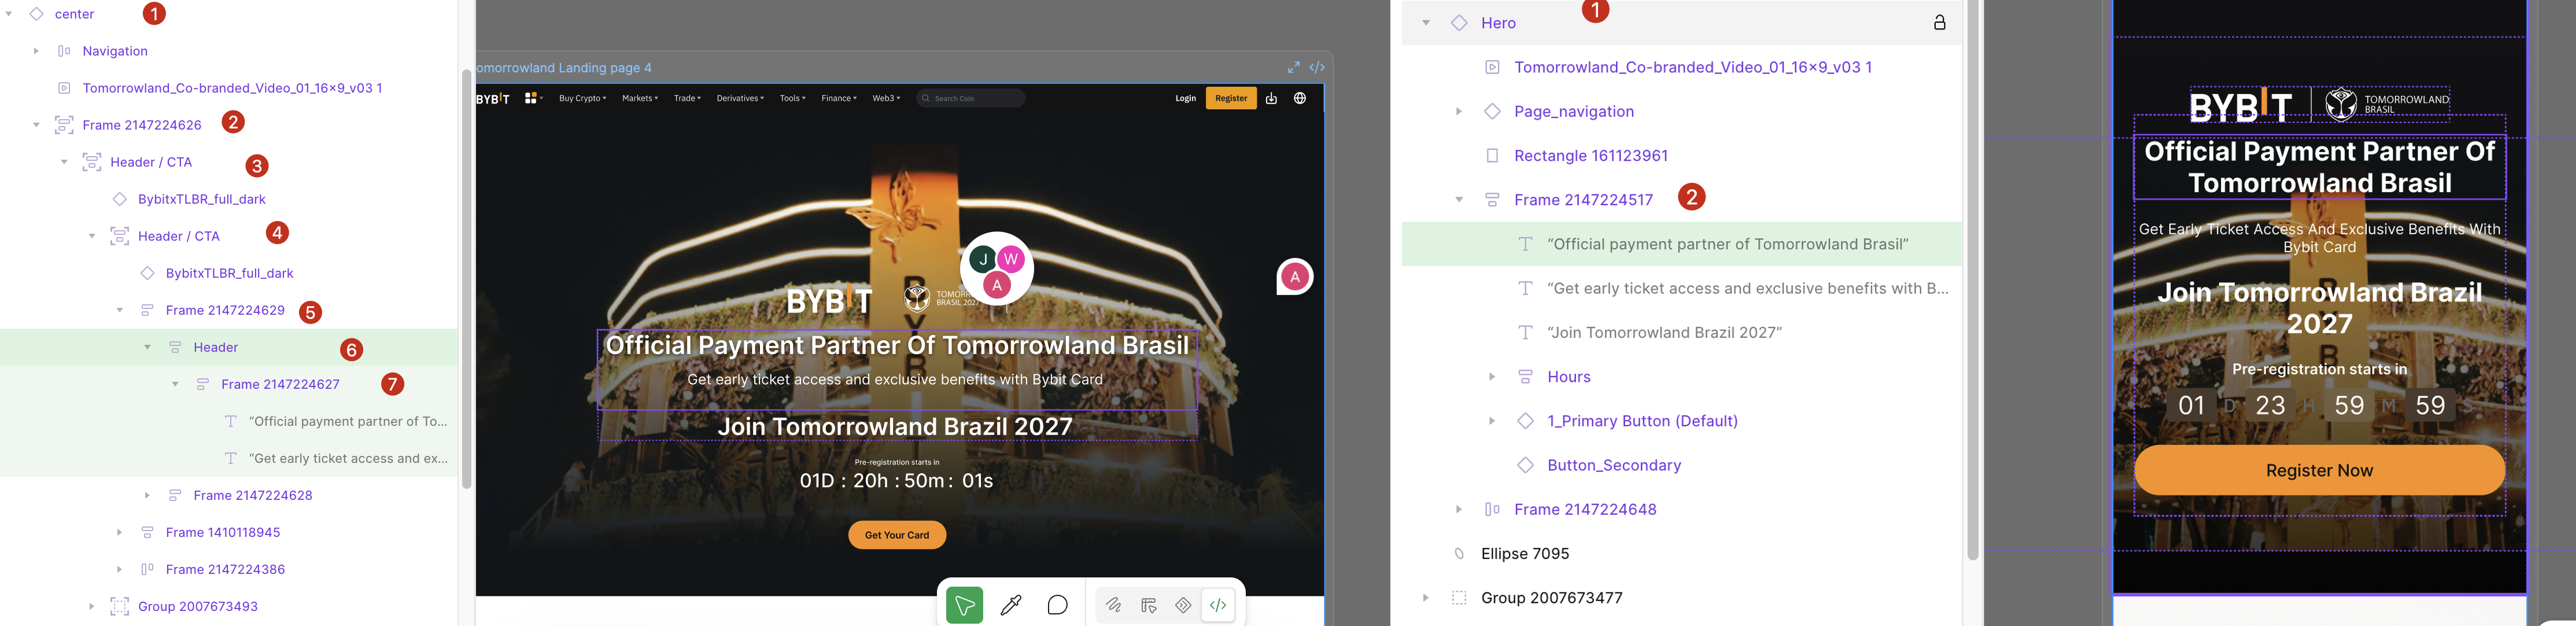
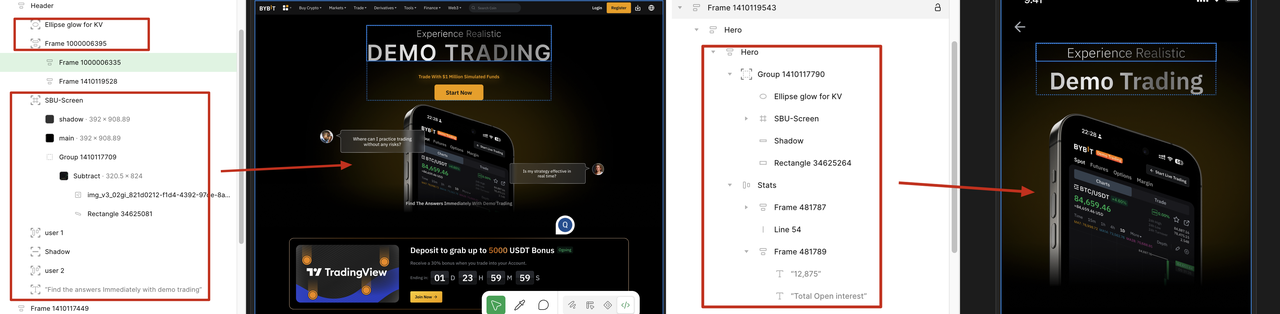
而另一个矛盾更本质:视觉还原从来不是孤立任务。一个真正能用的前端页面,还原视觉只是其中一环。它必须用项目自己的组件库,对接项目自己的 Design Token,遵守项目的代码规范。脱离项目上下文生成的代码,哪怕视觉完全一致,也是不能用的空壳。
两个矛盾叠加:信息形式不对 + 缺少项目规范接入,让视觉还原成为 AI Coding 工作流里最容易卡住的环节。
走过的两条弯路
在确立现在的方案之前,经历了两次方向性错误。
第一次尝试:让 AI 直接看设计稿截图写代码,用像素相似度(pixelmatch)循环迭代修正。想法是让 AI「看到」设计稿然后还原。结果是首轮还原度不稳定,迭代轮次不可预估,总消耗难以控制。
第二次尝试:把设计稿分块,用多个 Agent 并行处理,期待并行提速。结果是子 Agent 启动本身有开销,多个 Agent 同时控制浏览器截图时发生资源竞争,并行反而比串行慢。
两次失败有一个共同的根因:都在用 AI 做 AI 不擅长的事——从视觉图像估算精确数值。
Figma API 返回的本来就是结构化数据,每一个 padding、color、font-size 都是精确数值——根本不需要 AI 去「看图猜数字」。
问题不是 AI 能力不够,而是没有给它正确形式的信息。
换一个思路:不让 AI 猜,让 AI 查
核心翻转:把设计稿从「输入」变成「参考资料」。
不是把 Figma 数据直接处理成代码,而是把 Figma 数据变成一个可按需查询的信息源,让 Coding Agent 在写代码的过程中随时回查——就像一个有经验的前端开发者会反复切回设计稿确认细节。
这样做的前提是:Coding Agent 本身已经拥有代码生成能力和项目上下文。它知道该用什么组件库、遵守什么规范。它缺的只是「这里的 padding 到底是 16px 还是 20px」这类精确的视觉信息。
工具的职责因此变得清晰而有边界:把 Figma 原始数据降噪、结构化,以 AI 友好的方式暴露出来。代码生成完全由 Coding Agent 自己决定。
系统设计
整体架构
系统由三层构成:编排层(Skill)、转换层(双引擎)、数据与校验层。
- figma-to-code Skill 作为编排层,读取 SKILL.md 中的流程规范,决定调用哪个引擎以及各阶段的执行顺序
- 双引擎共用 Figma 数据源和 4 层校验,区别在于中间的转换策略
- Engine 2 在本地起一个 figma-context server,作为 Figma API 的代理层,AI 按需查询精确的 CSS 数值,而不是把整份 IR 塞进上下文。
两个引擎不是「新旧」或「好坏」关系,而是针对不同场景的不同策略:
| Engine 1(默认) | Engine 2(--light) | |
|---|---|---|
| 适合场景 | 像素级还原、复杂页面 | 快速原型、新技术栈 |
| 核心方式 | Python 管线,确定性执行 | AI 按需查询,自主写码 |
| 产出一致性 | 高,相同输入产出相同结果 | 一般,依赖 AI 当次判断 |
Engine 1:能确定性解决的,绝不交给 AI
Engine 1 的设计原则只有一句话:能用确定性解决的,绝不交给 AI。 各层的职责分配直接体现了这个原则:
数据获取层:extract.py 封装 Figma REST API 调用,figma_vars.py 解析设计系统的 Design Token 变量绑定。这是纯工程,不依赖 AI 推断,结果稳定。
IR 核心构建层(ir_builder.py):把原始节点树转换为与框架无关的中间表示(IR)。内部依赖三个子模块:css_extractor.py 提取 CSS 属性;layout_inference.py 推断 flex/grid 布局;node_classifier.py 判断节点类型(向量图形 / 装饰层 / 文字 / 组件实例)。布局推断、蒙版处理、节点分类——靠规则和算法,不依赖模型推断,结果稳定可重复。
代码生成层:tsx_generator.py 消费 IR 生成 TSX,scss_generator.py 生成对应的 Less/SCSS。
后处理层:token_resolver.py 做 Design Token 映射,brand_replace.py 去除品牌名,code_connect.py 把 Figma 组件实例替换为项目组件库引用。
AI 的职责只有一处:语义化组件拆分时,split_components.py 调用 AI 把 Frame123 这类自动编号改成 ProductCard 这类有语义的名字。理解层级关系和命名意图,这是 AI 擅长的。其余全部工程化。以下是 Engine 1 两个关键子模块的设计细节。
IR:脚本层与 AI 层的分工界面
IR 不只是数据格式,它是脚本层和 AI 层之间的职责边界。css 字段由脚本从 Figma API 精确提取,写入后冻结,AI 只读不推断;isComponentInstance 等分类信号是 AI 在整条管线中唯一能做判断的入口——判断这个节点是否对应一个已知组件,然后触发 Code Connect 查询。
Code Connect:组件库自动对接
当 isComponentInstance = true 时,Code Connect 决策流程启动:先查内置精确映射表,confidence = 1.0 直接替换(<Button variant="primary">),无需用户确认;未命中时通过 search_components 模糊搜索,找到后给用户确认;最终兜底是手写 <div> 保留 CSS 结构。Code Connect 配置越完整,fallback 到 div 的比例越低。
Engine 2:渐进式上下文
Engine 2 的策略是让 AI 「按需取用」——不一次性拿到所有信息,而是根据实现进度查询所需的部分:
GET /overview:整稿节点目录(只调一次,定位模块位置)GET /context/{nodeId}:单节点的精确 CSS 值 + 子节点分类 + 坐标(按需调,一次几百字节)GET /screenshot/{nodeId}:该节点的渲染截图 PNG(装饰节点合图用)
实现一个简单按钮,可能只需要调两次 API。实现一个复杂卡片,才需要深入到截图和多次 context 查询。每次查询只获取必要信息,上下文开销极低。有几条规则防止常见错误:所有 CSS 数值必须来自 API(不允许目测截图估算);position:absolute 叠层时 padding 必须用坐标差值计算;视觉修正循环最多 3 轮,超过则停止报告。
4 层校验:可量化的质量门禁
三层规则检查(Layer 0/1/2)加综合评分,共构成四道质量门禁。三层自动串行执行,每层发现问题都会扣分并给出改善提示:Layer 0 检查图片/SVG 资源是否完整落地;Layer 1 静态规则检查 Sass 变量合法性、flex/position 合规性;Layer 2 实际跑编译检查 Less/Scss 语法和 NaN/undefined 值。
综合评分 > 90 才允许落地,否则回到 P1 最多重跑 3 次。评分机制把「行不行」从人工主观判断变成可量化的数字,也让每次迭代的改善有了明确的参照。
双稿支持:PC + H5 各自自治
同时提供 PC 和 H5 两个 Figma URL 时,两端各自独立跑完整的 Engine 1 管线。PC 产出 MyPage/,H5 产出 MyPageH5/,最后通过 mv 重组合并到 src/pages/MyPage/,用 index.tsx 的 isMobile 判断运行时渲染哪端。
两端 CSS 完全独立,没有共享也没有合并逻辑。单端完全自洽,出问题可独立排查,不会因为一端改动影响另一端。
两个决策的本质
回看整个系统,有两个设计决策贯穿始终:
工程和 AI 的边界
CSS 提取、布局推断、Token 替换——确定性问题,工程来做。语义化命名、节点角色判断——需要理解能力,AI 来做。Coding Agent 做的是最核心的部分:结合项目上下文,用正确的组件、正确的规范写出能用的代码。
每一层只做自己最擅长的事——这不是工程哲学,是在有限上下文预算下唯一可靠的选择。
这个分工还带来一个重要的工程性质:还原效果与模型无关。从 Claude Haiku 到 Claude Opus,同一份设计稿的产出完全一致——因为决定还原质量的是确定性脚本,不是模型的推理能力。这也意味着可以在不牺牲还原效果的前提下,选择成本最低的模型来执行。
信息密度控制
传统方式把整份 IR 一次性传给 AI。figma-context server 把它拆成按需获取的 API。同样的信息,组织方式不同,对 AI 的帮助天壤之别。「减少噪音」和「提供正确信息」是同一件事的两面。
现实局限
- **PC和H5设计稿映射识别:**PC和H5设计稿同样区块内容的层级结构差异太大的时候难以做精准的响应式目前只能各自独立两套
- Figma 变量绑定率影响产出:设计师绑定了 Variables 时产出最好,未绑定时回退到 hex,token 匹配依赖对照表完整性
- Code Connect 覆盖依赖配置:只有正确配置了 Code Connect 的组件才能自动识别,其余 fallback 为 div
- 复杂交互不在范围:工具只做视觉层还原,动效、表单逻辑、接口联调不在覆盖范围
- Engine 2 一致性:相同设计稿两次转换结果可能有差异,不适合要求每次完全一致的场景
- 图层命名质量影响语义化:Figma 文件命名混乱时,AI 语义命名阶段的质量会下降
小结
- AI 视觉还原失败的根本原因,不是模型能力不够,而是拿到的信息形式不对——原始 Figma 节点树是给设计师的,不是给 AI 用的。
- 把设计稿从「输入」变成「随时可查询的参考资料」,让 Coding Agent 在有完整项目上下文的情况下按需获取视觉信息,这才是符合 Agent 工作方式的接入方案。
- 能用确定性解决的绝不交给 AI;工程和 AI 各司其职,才能构建出稳定可重复的产出。
- 视觉还原只是一个切口。工程化管线承担确定性工作、AI 承担理解类工作——这个分工原则,适用于 AI Coding 工作流里任何「精度要求高但上下文复杂」的场景。
项目地址
https://github.com/bybit-exchange/figma-to-code
欢迎使用 figma-to-code 并 star 支持我们!